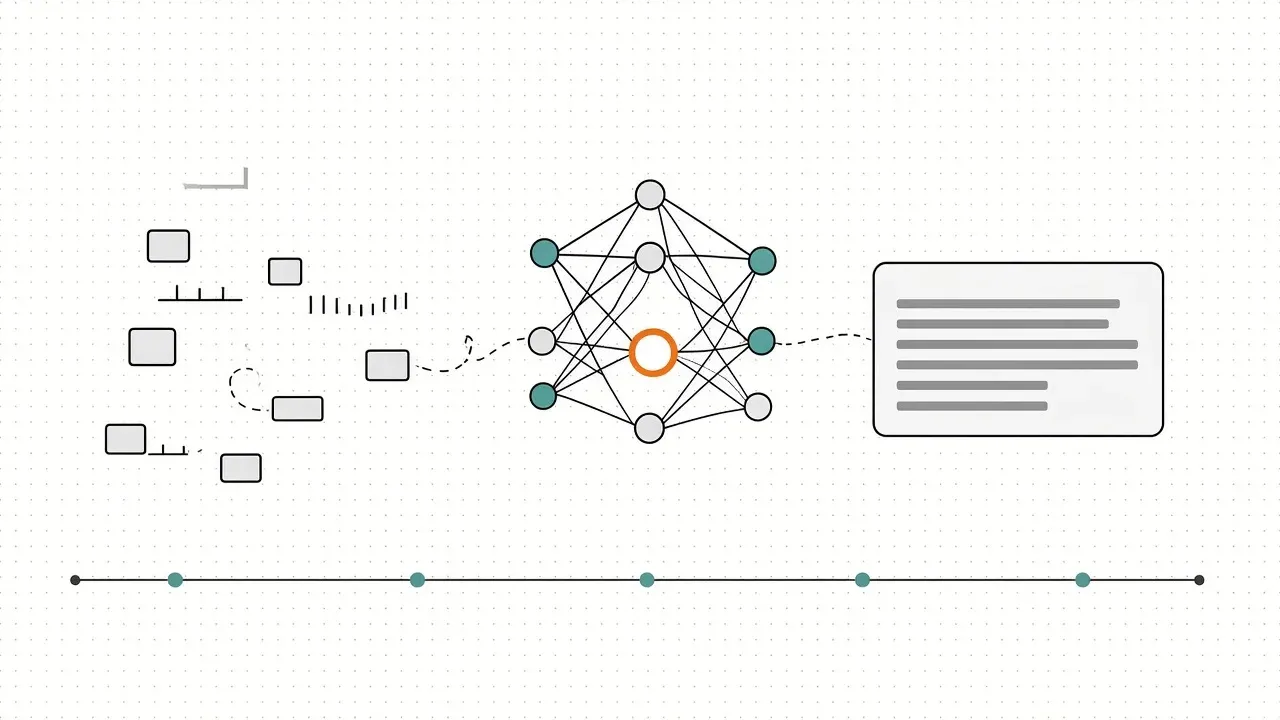
LLM (large language model, большая языковая модель) - это нейросеть, которую обучили на огромном объёме текста, чтобы она продолжала текст наиболее правдоподобным образом. На этом принципе работают ChatGPT, Claude, Gemini, GigaChat, Алиса и другие чат-боты: вы пишете вопрос, а модель по кусочкам достраивает ответ. Ниже разберём, как это устроено внутри, откуда у модели «знания», почему она иногда уверенно ошибается, чем LLM отличается от нейросетей вообще и какие модели есть на выбор.
LLM простыми словами
Представьте автодополнение в клавиатуре телефона, только натренированное не на ваших сообщениях, а на значительной части интернета, книг, документации и кода. Телефон подсказывает следующее слово. LLM делает то же самое, но настолько хорошо, что из цепочки подсказок получаются письма, код, переводы и объяснения.
Слово «большая» относится к двум вещам:
- размер модели - число параметров, то есть внутренних чисел, которые настраиваются при обучении. У современных моделей их от нескольких миллиардов до сотен миллиардов и больше;
- объём данных - модели учатся на триллионах токенов текста.
Чем больше параметров и данных, тем больше закономерностей языка и мира модель может уловить. Но размер - не единственный фактор: небольшая модель, обученная на качественных данных, нередко отвечает лучше крупной, обученной небрежно.
Как LLM генерирует ответ
Текст режется на токены
Модель не видит буквы и слова так, как человек. Текст сначала разбивается на токены - кусочки слов, короткие слова целиком, знаки препинания. Слово «нейросеть» может стать одним токеном или двумя-тремя, в зависимости от модели. Русский текст обычно дробится на большее число токенов, чем английский того же смысла, поэтому в платных API запросы на русском часто обходятся немного дороже и быстрее заполняют лимиты.
Модель предсказывает следующий токен
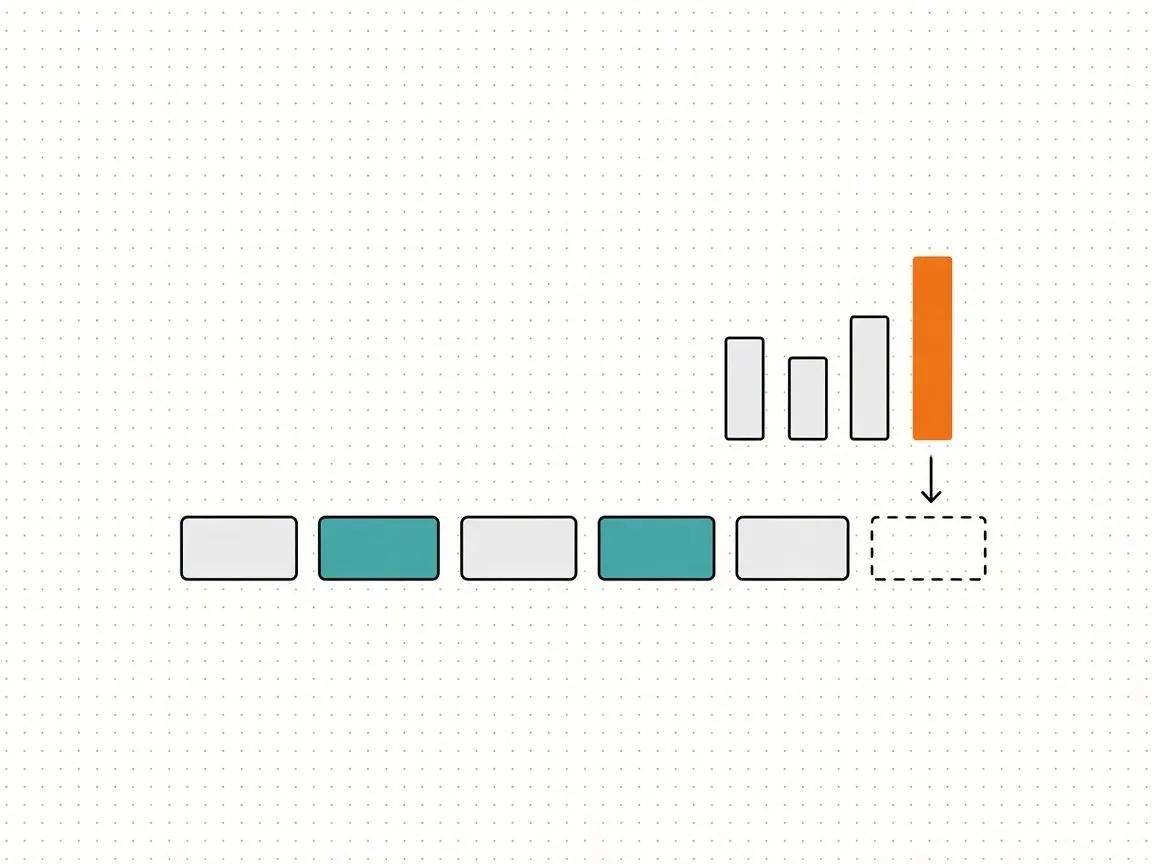
Каждый токен превращается в набор чисел (вектор). Модель прогоняет эти числа через десятки слоёв и на выходе даёт вероятности для всех возможных следующих токенов. Например, после фразы «Столица Франции называется» вероятность токена «Париж» будет очень высокой.
Затем выбирается один токен, добавляется к тексту, и всё повторяется. Ответ из 500 слов - это сотни таких шагов подряд. Поэтому в чат-ботах текст появляется постепенно, а не целиком.
Трансформер и механизм внимания
Почти все современные LLM построены на архитектуре трансформер. Её главная часть - механизм внимания (attention): при обработке каждого токена модель «смотрит» на все предыдущие и решает, какие из них важны прямо сейчас. Благодаря этому она понимает, к чему относится местоимение, держит тему разговора и связывает начало длинного абзаца с концом.
Температура: почему ответы разные
Модель не всегда берёт самый вероятный токен. Параметр температура управляет случайностью: при низкой ответы точнее и однообразнее, при высокой - разнообразнее, но с большим риском ошибок. Поэтому один и тот же вопрос, заданный дважды, может дать два разных ответа.
Как обучают большую языковую модель
Обучение идёт в несколько этапов, и у каждого своя задача.
- Предобучение (pretraining). Модели показывают огромный массив текста и учат угадывать следующий токен. Ошибка за ошибкой она подстраивает параметры. Это самый дорогой этап: он требует тысяч видеокарт и недель или месяцев работы. На выходе получается «базовая» модель, которая умеет продолжать текст, но ещё не умеет вести диалог.
- Дообучение на инструкциях (fine-tuning). Базовую модель дообучают на примерах «вопрос - хороший ответ», чтобы она выполняла просьбы, а не просто продолжала текст.
- Обучение на оценках людей (RLHF и похожие методы). Люди сравнивают варианты ответов, и модель учится выдавать те, что оценили выше: полезнее, точнее, безопаснее.
Из предобучения следует важное ограничение: знания модели заморожены на дате, когда закончили собирать данные. О более поздних событиях она не знает, если ей не дать доступ к поиску или документам.
Контекстное окно: память в пределах разговора
У LLM нет памяти в человеческом смысле. Всё, что она «помнит» в диалоге, - это текст, который ей передали вместе с вопросом: ваши прошлые сообщения, её ответы, прикреплённые файлы. Максимальный объём такого текста называется контекстным окном и измеряется в токенах.
Если разговор длиннее окна, начало отрезается, и модель его «забывает». У разных моделей окно отличается в десятки раз: от нескольких тысяч токенов у небольших локальных моделей до сотен тысяч и больше у крупных облачных. Для работы с длинными документами это один из главных параметров при выборе.
Почему LLM ошибается и выдумывает факты
Модель оптимизирована на правдоподобный текст, а не на истинный. Если правильного ответа в данных было мало, она всё равно сгенерирует что-то похожее на правду: несуществующую книгу, неверную дату, выдуманную функцию в библиотеке. Такие ошибки называют галлюцинациями.
Что помогает снизить риск:
- просить модель опираться на приложенный документ, а не на «свои знания»;
- включать поиск в интернете, если сервис это умеет;
- задавать вопрос конкретно и давать контекст;
- проверять цифры, цитаты, ссылки и код перед использованием.
На первом пункте построен RAG (retrieval-augmented generation): система сначала находит нужные фрагменты в базе документов, а потом передаёт их модели вместе с вопросом. Так работают чат-боты поддержки, которые отвечают по внутренней документации компании.
Чем LLM отличается от «нейросети» вообще
Нейросеть - широкое понятие: так называют любую модель из искусственных нейронов. Распознавание лиц, подбор рекомендаций, генерация картинок - тоже нейросети, но не LLM.
| Понятие | Что это | Пример |
|---|---|---|
| Искусственный интеллект (ИИ) | вся область, где машины решают «умные» задачи | шахматная программа, голосовой помощник |
| Машинное обучение | методы, где программа учится на данных, а не по жёстким правилам | антиспам-фильтр |
| Нейросеть | один из видов моделей машинного обучения | распознавание лиц на фото |
| LLM | нейросеть-трансформер, обученная на тексте | ChatGPT, GigaChat, Llama |
Так что на вопрос «LLM - это ИИ или нет» ответ такой: да, LLM - частный случай нейросети, а нейросети - часть ИИ.
Отдельно стоят мультимодальные модели. Они принимают не только текст, но и картинки, аудио, иногда видео. Внутри у них по-прежнему языковая модель, к которой добавили способ «переводить» изображение или звук в понятные ей векторы.
Какие LLM бывают
Версии моделей меняются часто, поэтому ниже - семейства, а не конкретные номера. Названия версий и тарифы лучше смотреть на сайте разработчика.
Облачные модели
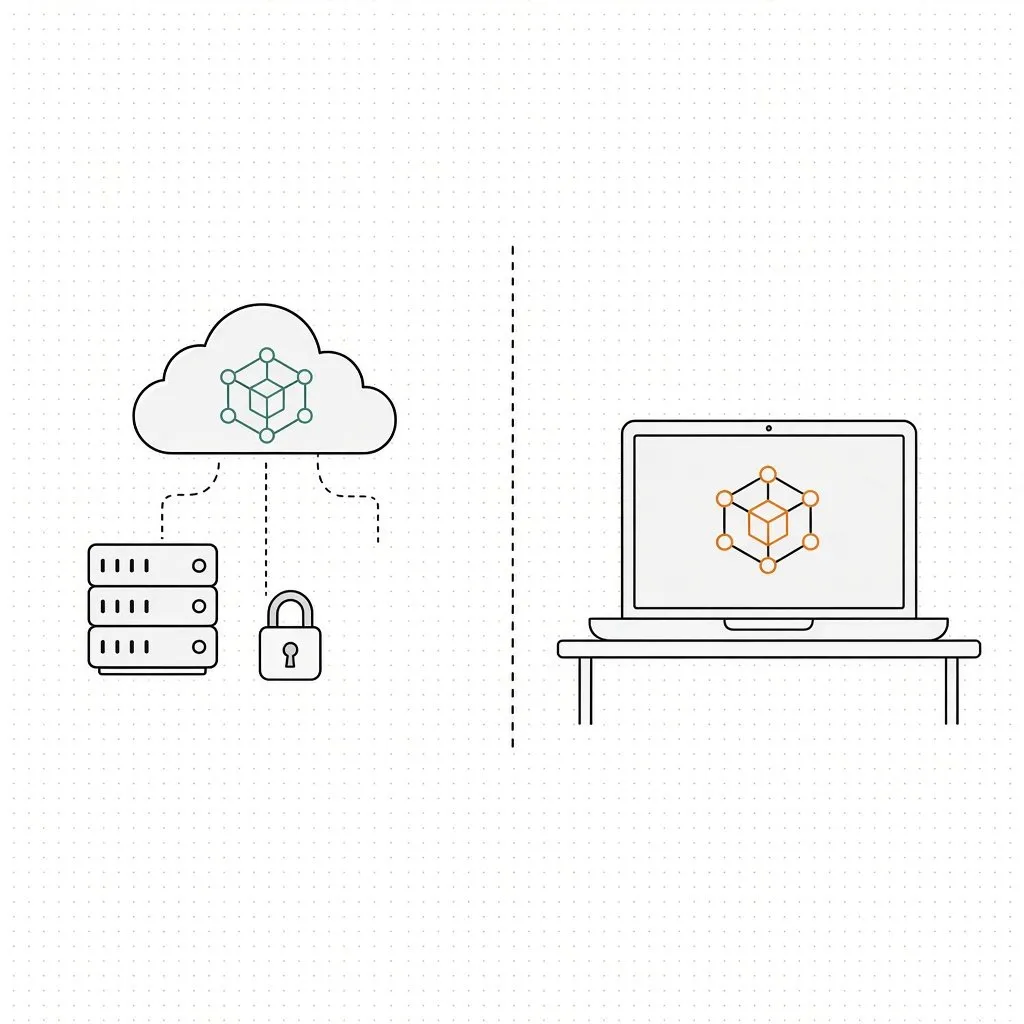
Работают на серверах компании, доступны через сайт, приложение или API. Железо не нужно, но запросы и файлы уходят на чужой сервер.
GPT (OpenAI, чат-бот ChatGPT)
- Бесплатно или платно: есть бесплатный тариф с лимитами, расширенные возможности - по подписке, API оплачивается за токены.
- Плюсы: универсальна, хорошо справляется с текстами, кодом и анализом файлов, умеет искать в интернете, работать с картинками и голосом.
- Минусы: официально не работает в России, для оплаты нужна иностранная карта.
Claude (Anthropic)
- Бесплатно или платно: бесплатный доступ с лимитами, подписка и платный API.
- Плюсы: сильна в работе с длинными документами и кодом, аккуратно следует инструкциям, пишет живым языком.
- Минусы: бесплатные лимиты заканчиваются быстро, не рисует картинки, официально недоступна в России.
Gemini (Google)
- Бесплатно или платно: базовая версия бесплатна, продвинутые модели - в платной подписке Google, API с бесплатным лимитом для разработчиков.
- Плюсы: встроена в Gmail, Документы и Android, хорошо работает с картинками, видео и длинными файлами.
- Минусы: официально недоступна в России.
GigaChat (Сбер)
- Бесплатно или платно: чат на сайте, в приложении и в ботах мессенджеров бесплатный, API для разработчиков - платные пакеты токенов.
- Плюсы: работает без VPN, хорошо знает русский язык и российский контекст, умеет генерировать картинки.
- Минусы: в сложном программировании и многошаговых рассуждениях обычно уступает лидерам рынка.
YandexGPT (Яндекс, работает в Алисе)
- Бесплатно или платно: базовая Алиса бесплатна, расширенные возможности - по подписке Яндекса, API в Yandex Cloud оплачивается за токены.
- Плюсы: без VPN, связана с Поиском и сервисами Яндекса, хорошо пересказывает статьи и видео на русском.
- Минусы: как и у GigaChat, в сложном коде и рассуждениях обычно слабее лидеров.
DeepSeek (Китай)
- Бесплатно или платно: чат бесплатный, API заметно дешевле, чем у западных конкурентов, веса многих моделей открыты.
- Плюсы: сильна в математике, программировании и пошаговых рассуждениях.
- Минусы: данные обрабатываются на серверах в Китае, в часы нагрузки сервис бывает перегружен.
Открытые модели, которые можно запустить у себя
Веса таких моделей выложены в открытый доступ: модель можно скачать и запустить на своём компьютере бесплатно, без интернета и без отправки данных наружу.
Llama (Meta)
- Плюсы: одно из самых популярных открытых семейств, много размеров и дообученных сообществом версий.
- Минусы: собственная лицензия с ограничениями, а не полностью свободная; русский язык слабее английского.
Qwen (Alibaba)
- Плюсы: размеры от лёгких до очень крупных, хорошо понимает русский и пишет код, большинство версий под свободной лицензией Apache 2.0.
- Минусы: крупные версии требуют мощной видеокарты, а маленькие заметно слабее в сложных задачах.
Mistral (Франция)
- Плюсы: компактные и быстрые модели, часть под лицензией Apache 2.0.
- Минусы: самые сильные модели компании закрытые и платные, русский язык не самая сильная сторона.
Gemma (Google)
- Плюсы: маленькие версии работают даже на слабом ноутбуке, есть версии, которые понимают картинки.
- Минусы: лицензия Google с условиями использования; маленькие версии быстро теряются на сложных задачах.
DeepSeek
- Плюсы: открытые веса сильных моделей и облегчённые версии для домашних компьютеров.
- Минусы: полная модель слишком велика для домашнего ПК, облегчённые заметно слабее.
Запускают открытые модели через программы вроде Ollama или LM Studio. Модель на 7-8 миллиардов параметров в сжатом виде работает на ноутбуке с 16 ГБ оперативной памяти, для крупных нужна мощная видеокарта. Главный минус: локальные модели обычно слабее топовых облачных.
Ограничения и модели без цензуры
У всех облачных моделей есть встроенные ограничения: на часть вопросов о политике, религии и других чувствительных темах они отвечают уклончиво или отказываются отвечать. Набор таких тем зависит от компании и страны, где она работает.
Среди открытых моделей, которые запускают у себя, есть версии, у которых эти ограничения убраны. Обычно в названии стоит пометка uncensored или abliterated. Такая модель ответит на любой вопрос, но галлюцинирует так же, как обычная, а фильтра у её ответов нет. С ними нужно быть аккуратнее: проверять факты и помнить, что ответственность за то, как использовать ответ, целиком на пользователе.
Что выбрать
| Задача | Что подойдёт |
|---|---|
| Попробовать без VPN и оплаты | GigaChat, Алиса, DeepSeek |
| Длинные документы, сложный код | Claude, GPT, Gemini, DeepSeek |
| Данные нельзя отправлять наружу | открытые модели локально: Qwen, Llama, Gemma |
| Слабый ноутбук без видеокарты | небольшие версии Gemma или Qwen |
Где LLM полезна, а где нет
Хорошо получается:
- черновики писем, статей, описаний;
- пересказ и выжимка длинных текстов;
- перевод и правка стиля;
- объяснение кода, поиск ошибок, написание скриптов;
- ответы по документам, если их приложить.
Плохо или рискованно:
- точные расчёты без встроенного калькулятора или кода - модель может ошибиться в арифметике;
- свежие новости без доступа к поиску;
- юридические, медицинские и финансовые решения без проверки специалистом;
- факты, которые нельзя проверить: модель ответит уверенно, даже если не знает.
Качество ответа сильно зависит от запроса. Чем точнее вы описали задачу, формат и контекст, тем лучше результат.
Коротко
LLM - большая нейросеть-трансформер, которая учится на тексте и генерирует ответ, предсказывая токен за токеном. Её знания ограничены данными обучения, память - контекстным окном, а правдоподобный ответ не всегда правдивый. Облачные модели дают лучшее качество без требований к железу, открытые можно бесплатно запустить на своём компьютере, не отправляя данные наружу.
Комментарии
Комментариев пока нет - будьте первым.