LM Studio - бесплатная программа для Windows, macOS и Linux, которая запускает языковые модели прямо на вашем компьютере: без интернета, подписки и отправки данных на чужие серверы. В ней есть встроенный каталог моделей, чат в привычном интерфейсе и локальный сервер с API, совместимым с OpenAI. Главный вопрос при работе с ней - какую модель и какой квант выбрать под объём памяти, иначе всё упирается в ошибку «Failed to load model». Ниже разберём установку, выбор кванта под 8, 16 и 32 ГБ, импорт своих GGUF-файлов и типичные ошибки.
Что умеет LM Studio
- Каталог моделей. Поиск по Hugging Face прямо из программы, с пометкой, поместится ли модель в вашу видеопамять.
- Чат. Несколько диалогов, системный промпт, вложения файлов для работы с документами, настройка температуры и длины ответа.
- Локальный сервер. API по адресу
http://localhost:1234/v1в формате OpenAI, к нему подключаются редакторы кода, плагины и свои скрипты. - Два движка. llama.cpp для файлов GGUF на любом железе и MLX для Mac на Apple Silicon, который там обычно работает быстрее.
- Консольная утилита
lms. Загрузка моделей и запуск сервера без графического интерфейса.
Программа бесплатна для личного и рабочего использования. Исходный код самого приложения закрыт, открыты движки и CLI.
Системные требования
| Минимум | Комфортно | |
|---|---|---|
| Windows | x64-процессор с AVX2 или ARM (Snapdragon X), 16 ГБ ОЗУ | видеокарта NVIDIA или AMD с 8 ГБ видеопамяти и больше |
| macOS | Mac на Apple Silicon (M1 и новее), актуальная macOS | 16 ГБ общей памяти и больше |
| Linux | x64 с AVX2, Ubuntu 20.04 и новее, AppImage | видеокарта с поддержкой CUDA или Vulkan |
| Диск | 10-20 ГБ под пару моделей | SSD, модели загружаются в память в разы быстрее |
Mac на процессорах Intel не поддерживаются. Без видеокарты LM Studio тоже работает, но только на процессоре, и ответы небольших моделей будут идти со скоростью несколько слов в секунду.
Установка и первая модель
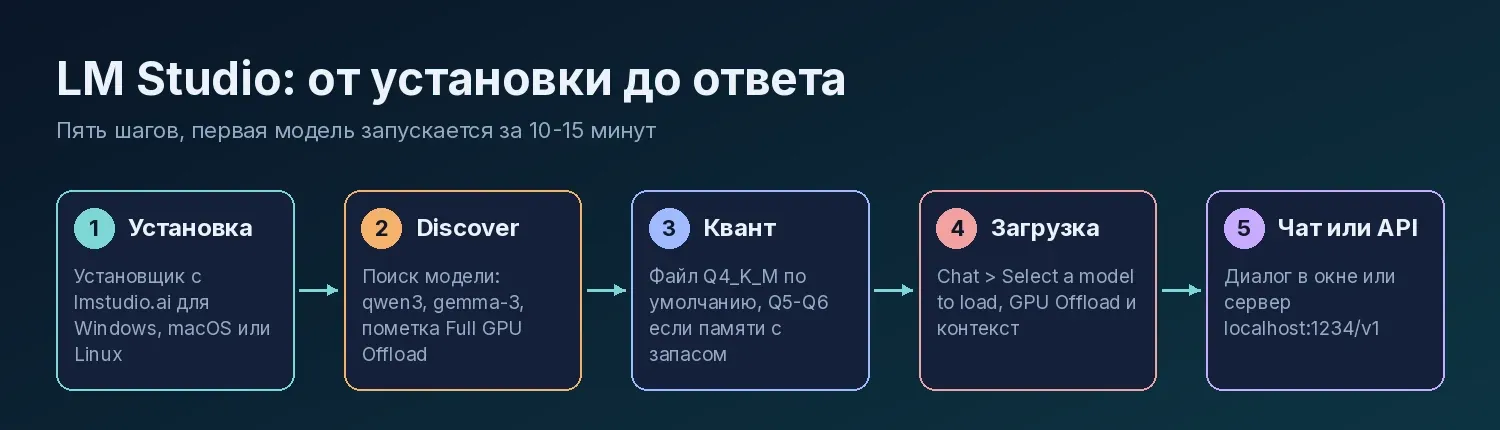
- Скачайте установщик с lmstudio.ai для своей системы и установите как обычную программу. На Linux сделайте AppImage исполняемым:
chmod +x LM-Studio-*.AppImage. - При первом запуске программа предложит скачать стартовую модель. Можно согласиться или пропустить и выбрать самому.
- Откройте вкладку Discover (значок лупы), введите название модели, например
qwen3илиgemma-3. - Справа выберите файл нужного кванта и нажмите Download. Пометка Full GPU Offload Possible значит, что модель целиком поместится в видеопамять.
- Перейдите в Chat, вверху нажмите «Select a model to load» и выберите скачанную модель.
Если у вас уже стоит Ollama и вы сравниваете инструменты, разница в подходе: у LM Studio всё в окне программы, у Ollama - консоль и фоновая служба. Как работает Ollama, мы разбирали в статье Ollama: как установить и запустить нейросеть на своём компьютере.
Что такое квант и какой выбрать
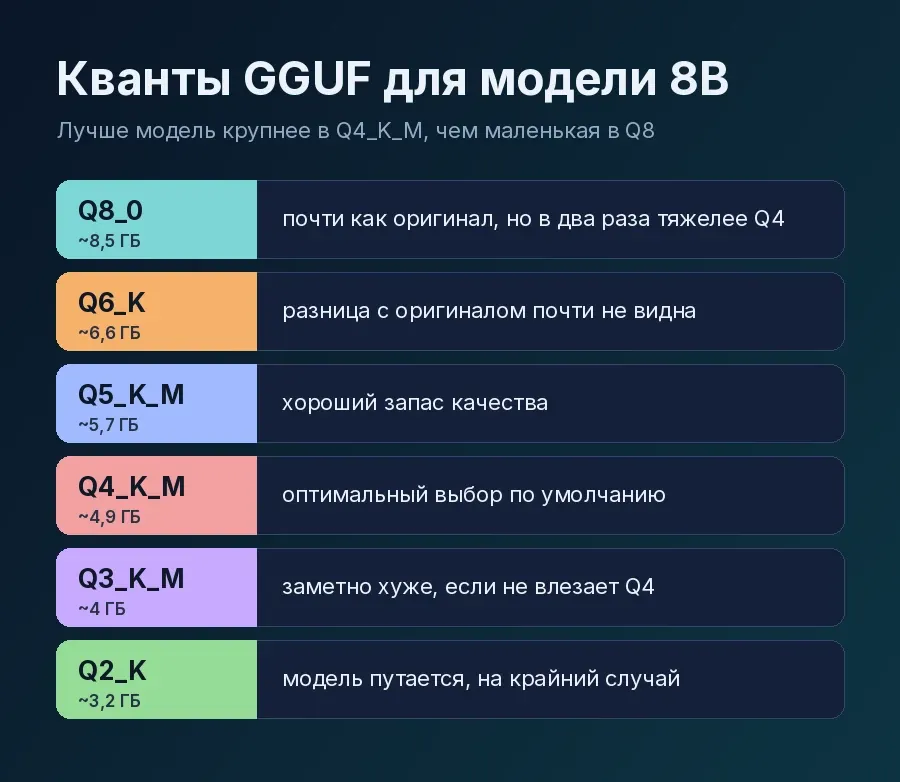
Модель хранит миллиарды чисел-весов. В оригинале каждый вес занимает 16 бит, и модель на 8 миллиардов параметров весит около 16 ГБ. Квантизация сжимает веса до 8, 6, 5 или 4 бит. Файл и потребление памяти уменьшаются в 2-4 раза, а качество падает незаметно до уровня примерно 4 бит, дальше заметнее.
Названия квантов в файлах GGUF выглядят так:
| Квант | Бит на вес, примерно | Размер модели 8B | Качество |
|---|---|---|---|
| Q8_0 | 8,5 | ~8,5 ГБ | почти как оригинал, но тяжело |
| Q6_K | 6,6 | ~6,6 ГБ | разница с оригиналом почти не видна |
| Q5_K_M | 5,7 | ~5,7 ГБ | хороший запас качества |
| Q4_K_M | 4,8 | ~4,9 ГБ | оптимальный выбор по умолчанию |
| Q3_K_M | 3,9 | ~4 ГБ | заметно хуже, только если не влезает Q4 |
| Q2_K | 3,4 | ~3,2 ГБ | модель путается, на крайний случай |
Правило простое: лучше модель покрупнее в Q4_K_M, чем маленькая в Q8. Модель на 14 миллиардов параметров в четырёх битах обычно отвечает умнее, чем 7B в восьми.
Сколько памяти нужно
К размеру файла добавьте 1-2 ГБ на контекст (память диалога) и систему. На Windows и Linux считайте видеопамять отдельно от ОЗУ: если модель не влезает в видеокарту целиком, часть слоёв останется в ОЗУ на процессоре, и скорость упадёт в разы. На Mac память общая, но система отдаёт видеоядру не всю: примерно две трети-три четверти от объёма.
| Доступно памяти (VRAM или общей на Mac) | Что запустится комфортно |
|---|---|
| 6-8 ГБ | модели 3-4B в Q6-Q8, 7-9B в Q4_K_M впритык |
| 12 ГБ | 7-9B в Q6_K, 12-14B в Q4_K_M |
| 16 ГБ | 12-14B в Q5-Q6, 20-24B в Q4_K_M |
| 24 ГБ | 27-32B в Q4_K_M |
| 32 ГБ и больше | 27-32B в Q5-Q6, 70B только в Q2-Q3 или на 48+ ГБ |
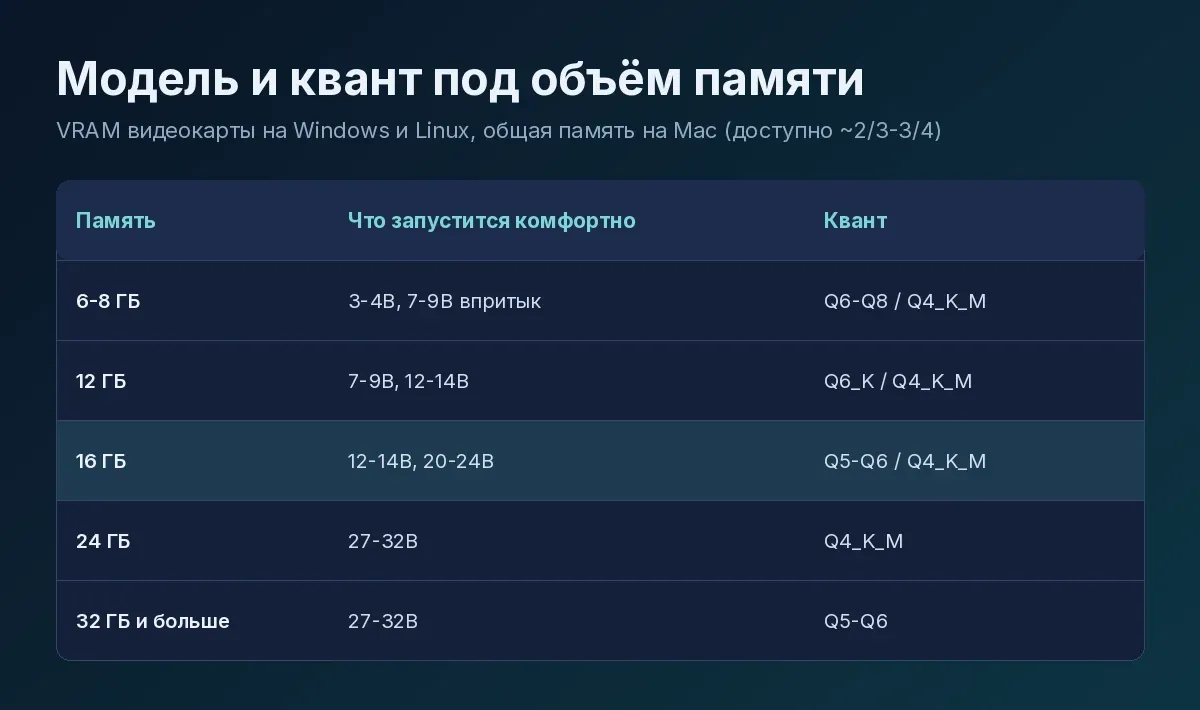
Узнать объём видеопамяти на Windows можно в диспетчере задач: «Производительность» > «Графический процессор» > «Выделенная память графического процессора».
Настройки при загрузке модели
Если при выборе модели включить «Manually choose model load parameters» или раскрыть настройки справа, появятся три важных параметра:
- GPU Offload - сколько слоёв модели положить в видеопамять. Максимум даёт лучшую скорость, если памяти хватает. При ошибке загрузки уменьшайте по 5-10 слоёв.
- Context Length - сколько токенов модель держит в памяти диалога. Каждое удвоение заметно увеличивает потребление памяти. Для чата хватает 4096-8192, для работы с длинными документами ставят больше.
- Flash Attention - экономит память на длинном контексте, на современных видеокартах стоит включить.
Что такое токены и почему от них зависит контекст, объяснено в статье Что такое LLM.
Как загрузить свою модель GGUF
Если файл скачан вручную с Hugging Face или передан коллегой, есть два способа.
Через консоль:
lms import путь/к/model-Q4_K_M.gguf
Утилита спросит, переместить или скопировать файл, и положит его в папку моделей.
Вручную: откройте вкладку My Models, посмотрите путь к папке моделей (по умолчанию ~/.lmstudio/models, на Windows C:\Users\имя\.lmstudio\models) и создайте внутри две вложенные папки - автор и название модели:
.lmstudio/models/
  mistralai/
    Mistral-7B-Instruct/
      mistral-7b-instruct-Q4_K_M.gguf
Без двух уровней папок программа файл не увидит. Папку моделей можно перенести на другой диск в той же вкладке My Models.
Локальный сервер и API
На вкладке Developer включите переключатель Status: Running или выполните в консоли:
lms server start
Проверить, что сервер отвечает:
curl http://localhost:1234/v1/models
К этому адресу подключаются любые программы, которые умеют работать с OpenAI API: в них указывают Base URL http://localhost:1234/v1 и любой непустой ключ. Чтобы сервером пользовались другие компьютеры в сети, включите в его настройках «Serve on Local Network».
Ошибки LM Studio и как их исправить
| Сообщение | Причина | Что сделать |
|---|---|---|
| Failed to load model | не хватает видеопамяти или ОЗУ | уменьшить GPU Offload и Context Length, взять квант на ступень меньше или модель поменьше |
| Model loading was stopped due to insufficient system resources | сработала защита от перегрузки памяти | закрыть тяжёлые программы, выбрать модель меньше; ограничение настраивается в Settings > Model loading guardrails |
| unknown model architecture | движок старее, чем модель | обновить Runtime: Settings > Runtime или Ctrl+Shift+R, скачать свежий llama.cpp |
| Модель отвечает очень медленно | слои ушли на процессор | проверить, что выбран CUDA или Vulkan-движок, поставить GPU Offload на максимум, взять модель меньше |
| Модель не видна после копирования файла | нет вложенных папок автор/модель | разложить файл по двум уровням папок или использовать lms import |
| Ответы обрываются или повторяются | слишком маленький контекст или неподходящий шаблон чата | увеличить Context Length, скачать модель с пометкой Instruct |
Какие модели попробовать первыми
Для русского языка и общих задач хорошо себя показывают семейства Qwen3 и Gemma 3: у обоих есть размеры от 4 до 30 с лишним миллиардов параметров, так что подходящая найдётся почти под любую память. Для кода стоит посмотреть версии с пометкой Coder. Модели с рассуждением (thinking) сначала выводят ход мысли, а потом ответ - они точнее в задачах на логику, но отвечают дольше.
После текстовых моделей многие переходят к генерации картинок на своём компьютере. Для этого LM Studio не подходит, там используют отдельные программы на основе Stable Diffusion и Flux.
Комментарии
Комментариев пока нет - будьте первым.